Ingeniería con IA · Proceso de ingeniería
Tiempo de lectura · 7 min
Las pruebas en verde no bastan: cómo revisamos código generado por IA
Cómo revisamos el código generado por IA más allá de las pruebas aprobadas, atendiendo invariantes, límites arquitectónicos, propiedad del estado, comportamiento ante fallos, mantenimiento y criterio humano.
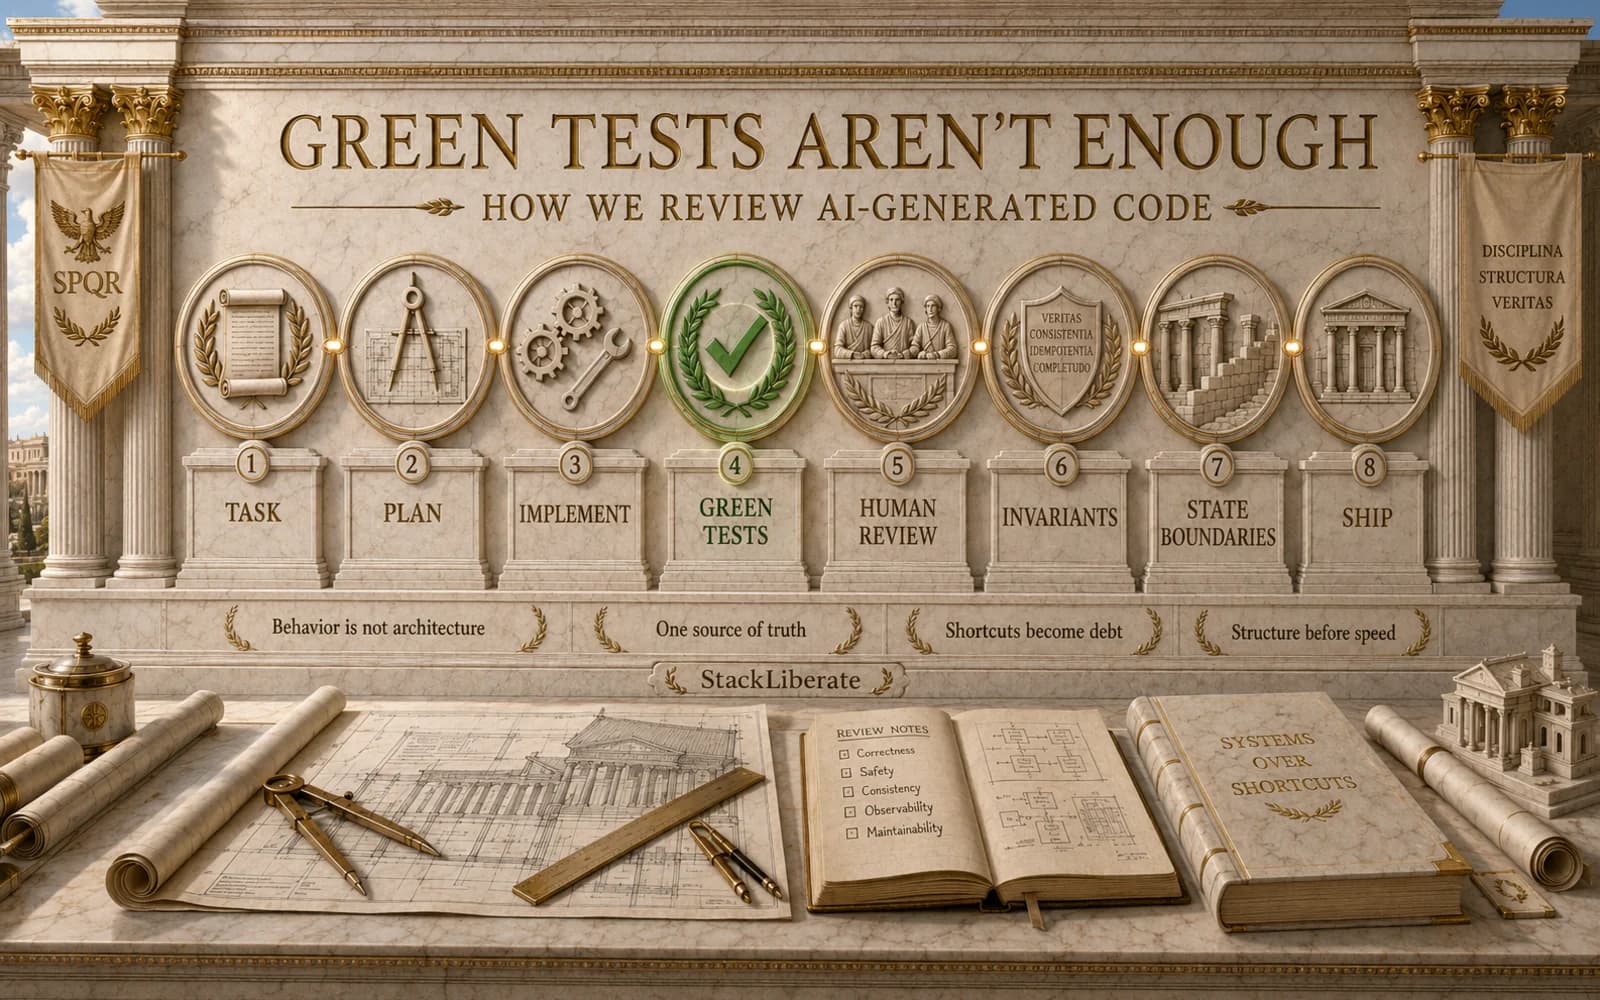
Uno de los errores más fáciles con código generado por IA también es de los más tranquilizadores:
La compilación pasa.
Los tipos son correctos.
Las pruebas están en verde.
La función trabaja bien.
Publícalo.
Esas señales importan. Las queremos todas.
Simplemente no las consideramos suficientes.
Los agentes producen cada vez mejor implementaciones que satisfacen una tarea local. A la vez, el sector descubre que revisar software generado por agentes exige mirar más allá de que un cambio produzca la salida esperada. GitHub amplió su revisión con IA hacia un contexto de repositorio más amplio y la «integridad arquitectónica», mientras OpenAI describe imponer mecánicamente límites e invariantes en una base con muchos agentes, sin depender solo de documentación o pruebas.
Esto coincide con una lección de construir StackLiberate:
Una prueba puede demostrar que un comportamiento observado funciona en las condiciones que cubre. No puede demostrar por sí sola que se implementó en el lugar correcto.
Esa diferencia orienta cómo revisamos código generado por IA.
Comportamiento correcto y arquitectura correcta son preguntas distintas
Considera una función que debe actualizar estado del proyecto.
Un agente encuentra un componente que muestra el valor, introduce estado local, actualiza la interfaz, añade pruebas y produce exactamente el comportamiento visible pedido.
Todas las afirmaciones pueden pasar.
Pero supongamos que la aplicación ya tiene un modelo autoritativo responsable de persistencia, recarga, historial y otra representación del mismo proyecto.
La nueva implementación funciona.
También es incorrecta.
Creó un segundo lugar donde el sistema cree que vive la verdad.
Las pruebas del componente nuevo quizá nunca lo revelen.
Esta clase de problema es la que más nos importa al revisar.
No:
¿Devuelve esta función el valor correcto?
sino:
¿Esta implementación sigue respetando cómo debe funcionar el sistema?
Ambas importan. Operan a distintos niveles.
Los agentes son muy buenos para los atajos localmente razonables
No es porque sean descuidados.
Con frecuencia ocurre lo contrario.
La implementación peligrosa suele ser limpia, tener tipos y pruebas y ser fácil de explicar. El atajo aparece porque el agente optimiza desde el contexto que tiene.
Si un comportamiento se implementa:
- añadiendo una variable de estado local,
- introduciendo una función pequeña,
- duplicando una transformación,
- dando trato especial a una ruta de renderizado,
- o eludiendo una abstracción compartida más compleja,
la solución puede parecer totalmente razonable.
El problema solo aparece cuando el revisor entiende el ciclo completo.
¿Qué pasa tras recargar?
¿Durante una restauración?
¿En otra ruta?
¿Quién es responsable de este estado?
¿Existe otro escritor?
¿La exportación reconstruye el mismo resultado?
¿Se elude un límite de autorización?
¿Resolvimos el contrato general o solo el caso visible de hoy?
Puede no haber un error obvio en el código. El error arquitectónico es que el comportamiento pertenece a otro lugar.
La investigación reciente refuerza la diferencia entre generar pruebas y establecer corrección más amplia. Un estudio empírico de 2026 encontró que aumentar las pruebas escritas por agentes no mejoró significativamente los resultados finales de resolución de problemas entre los agentes estudiados. Por separado, una síntesis de investigación empírica encontró que la calidad del código generado varía en corrección, seguridad, mantenimiento y complejidad, según las especificaciones, experiencia humana, comportamiento del modelo y flujo de trabajo.
Más pruebas pueden aportar valor.
No sustituyen saber qué debe ser cierto.
Revisamos contra invariantes
Para cambios importantes, la revisión de StackLiberate empieza antes de implementar.
El plan suele establecer unas pocas invariantes: propiedades que la función no puede vulnerar.
Pueden referirse a:
- Qué representación tiene autoridad.
- Qué capa es responsable de una transición.
- Si un cambio debe sobrevivir a recarga.
- Si historial y restauración deben reconstruirlo.
- Si deben rechazarse escrituras obsoletas.
- Si un comportamiento público existente debe permanecer intacto.
- Si vista previa y archivos portables deben preservar el mismo resultado creado.
Después revisamos la implementación contra esas propiedades.
Esto permite una pregunta más sólida que:
¿Implementó correctamente el agente su propio plan?
Podemos preguntar:
¿El sistema resultante preservó los contratos que acordamos importantes?
OpenAI describe una distinción similar en su ingeniería con agentes: en vez de supervisar cada implementación, el equipo codifica límites arquitectónicos, dirección de dependencias, pruebas estructurales, nombres y otras invariantes que los agentes deben preservar. Su argumento es pertinente al desarrollar con alto volumen: las restricciones valen más cuando implementar es más barato.
Por eso también nos importa la arquitectura.
No porque cada función necesite una abstracción elaborada.
Sino porque debería seguir siendo difícil cruzar accidentalmente ciertos límites.
Las pruebas validan comportamiento. Los límites validan estructura.
Las pruebas automatizadas tradicionales responden muy bien a preguntas como:
Dada esta entrada,
¿se produce esta salida?
También prueban integraciones, navegador, persistencia, fallos y recorridos completos.
Pero algunas propiedades se comprueban mejor de otra forma.
Supongamos esta regla:
Solo un subsistema puede escribir este estado.
Puedes probar el comportamiento de cada recorrido conocido.
O puedes hacer tan explícito el límite que sea detectable mecánicamente vulnerarlo.
Del mismo modo:
Este paquete de ejecución nunca debe depender de esta capa de interfaz.
Es una regla fundamentalmente estructural.
Los sistemas de ingeniería más sólidos combinan evidencias:
Tipos
   +
Restricciones estáticas
   +
Pruebas unitarias
   +
Pruebas de contrato e integración
   +
Comportamiento de extremo a extremo
   +
Revisión arquitectónica
Ninguna sustituye a las demás.
Por eso Kiro impulsa enfoques guiados por especificaciones y propiedades: no basta que pasen ejemplos; importa seguir satisfaciendo propiedades derivadas del comportamiento previsto.
Usamos la misma idea aunque difiera el mecanismo:
definir lo que debe seguir siendo cierto y validarlo donde realmente vive esa propiedad.
Buscamos la segunda fuente de verdad
Una de nuestras preguntas de revisión más valiosas es sencilla:
¿Creó este cambio otra autoridad para algo que ya tenía una?
La IA abarata duplicar.
Si cuesta alcanzar una abstracción existente, el agente puede recrear cerca parte del comportamiento.
A veces no hace daño.
Otras veces crea dos implementaciones que coinciden hoy y divergen seis funciones después.
Puede pasar con:
- Estado.
- Validación.
- Saneamiento.
- gestión de recursos;
- serialización;
- rutas;
- permisos;
- interfaz derivada;
- lógica de transformación.
No buscamos solo líneas duplicadas.
Buscamos responsabilidades duplicadas.
Dos implementaciones pueden no compartir código y aun así competir como fuentes de verdad.
Eso es mucho más difícil de detectar con una prueba unitaria convencional.
Inspeccionamos los límites del estado
Los productos con mucho estado lo hacen especialmente importante.
Un valor visible puede existir a la vez como:
- Estado temporal de interfaz.
- Estado del proyecto.
- Estado persistido.
- Una versión histórica.
- Una proyección renderizada.
- Una representación exportada.
Varias representaciones no son necesariamente un problema.
Confundir su autoridad sí.
Cuando un cambio toca estado significativo, preguntamos:
- ¿Dónde nace la transición?
- ¿Qué representación adquiere autoridad?
- ¿Qué otros estados son derivados?
- ¿Quién puede escribir?
- ¿Qué pasa si se superponen operaciones?
- ¿Qué pasa tras reconstruir?
- ¿Puede una proyección divergir sin detectarse?
Estas revisiones detectan problemas invisibles en la función modificada.
El código se ve bien porque está bien.
El problema está en su límite.
También revisamos el comportamiento ante fallos
Las pruebas en verde dirigen naturalmente la atención al éxito.
La revisión debe incluir qué pasa si el éxito se detiene a la mitad.
Para una operación significativa queremos saber:
- ¿Qué queda intacto si falla la validación?
- ¿Puede persistir una operación parcialmente?
- ¿Puede un reintento duplicar trabajo?
- ¿Qué pasa con estado obsoleto?
- ¿Una respuesta tardía sobrescribe algo nuevo?
- ¿La interfaz afirma algo rechazado por el estado autoritativo?
- ¿La recuperación es explícita?
No significa que toda función requiera mecanismos complejos de sistemas distribuidos.
Significa que los fallos deben tener un significado deliberado.
Un agente hace funcionar rápido el caso exitoso.
La revisión pregunta si el caso fallido deja un sistema que aún entendemos.
La IA puede participar en la revisión
Esto no implica que la IA solo genere código y las personas inspeccionen cada línea después.
Los agentes son revisores cada vez más capaces.
El sistema de GitHub recupera contexto circundante del repositorio para razonar más allá de la diferencia y permite instrucciones y habilidades específicas. OpenAI describe ciclos donde agentes inspeccionan e iteran el trabajo de otros agentes.
También usamos mucho la IA al revisar.
Un agente puede ser excelente para:
- Rastrear recorridos afectados.
- Encontrar lógica duplicada.
- Comprobar si se siguió el plan.
- Buscar fallos no contemplados.
- Comparar la implementación con restricciones documentadas.
- Ejecutar validación.
- Cuestionar supuestos de otro agente.
- Buscar efectos inesperados.
La distinción importante es que el revisor necesita una pregunta independiente.
Pedir:
«Revisa tu trabajo y dime si es bueno».
es más débil que:
«Verifica que esta implementación preserve estas cinco invariantes e identifica cada recorrido que pueda modificar este estado».
La calidad mejora cuando la revisión tiene un contrato.
También para las personas.
La revisión humana sube de nivel
Al mejorar los modelos, esperamos menos valor de revisar manualmente cada línea sintácticamente obvia.
Martin Fowler describió recientemente una distinción útil entre vibe coding y programación con agentes: en la segunda, las personas siguen siendo responsables de lo que hace el software y de cómo funciona aunque los agentes produzcan código.
Describe bien nuestra dirección.
La atención humana es escasa.
Preferimos dedicarla a preguntar:
- ¿Es necesaria esta abstracción?
- ¿La responsabilidad está en el lugar correcto?
- ¿Se amplió el alcance innecesariamente?
- ¿Se está confundiendo un atajo con un contrato?
- ¿Preservamos las invariantes existentes?
- ¿Es aceptable el comportamiento ante fallos?
- ¿Podrá alguien, u otro agente, entenderlo dentro de seis meses?
Aportan más que discutir si una función auxiliar debía tener tres líneas o cinco.
La IA puede generar muchísimo código.
El papel humano implica cada vez más decidir qué estructuras merecen sobrevivir.
Una compilación en verde es un punto de control, no un veredicto
Nos gustan las compilaciones en verde.
Nos dicen algo importante.
La implementación compila. Se mantienen comportamientos conocidos. Los controles automatizados no detectaron regresiones en las propiedades que cubren.
Eso es evidencia.
Después continúa la revisión.
Para cambios importantes pensamos más bien así:
¿Funciona?
      ↓
¿Las pruebas demuestran el comportamiento previsto?
      ↓
¿Preserva las invariantes acordadas?
      ↓
¿El estado tiene su responsable en el lugar correcto?
      ↓
¿Los límites ante fallos siguen explícitos?
      ↓
¿Añadimos un atajo que será la arquitectura de mañana?
      ↓
¿El sistema sigue siendo comprensible?
Solo las dos primeras preguntas tratan principalmente de pruebas en verde.
Las demás tratan de ingeniería.
La IA lo hace más importante
El costo de producir código plausible cayó enormemente.
Es una ventaja extraordinaria.
También permite crear deuda arquitectónica más rápido.
Una abstracción débil ya no exige dos días de implementación. Un agente puede construirla, documentarla, probarla e integrarla antes del almuerzo.
La respuesta natural no es frenar al agente hasta volver al proceso antiguo.
Es trasladar más criterio a donde tiene mayor impacto:
antes de implementar, en los límites arquitectónicos y durante la aceptación.
Para StackLiberate, las pruebas en verde son parte del criterio.
No son todo el criterio.
Queremos que la función trabaje bien.
También queremos que pertenezca al lugar correcto.
Esa distinción es, cada vez más, donde ocurre la ingeniería más importante.